面向嵌入式视觉系统的体素化三维高斯稠密视觉 SLAM
TL;DR 面向嵌入式系统提出体素化三维高斯稠密视觉 SLAM,结合冗余自适应剔除与属性量化压缩实现高精度建图与实时相机跟踪。
 紧凑高斯地图随机器人运动逐步构建。
稠密建图与存储开销
基于稀疏特征的 SLAM 精度不错,但地图太稀疏,派不上用场。导航、路径规划和避障要的是表面信息,而不是一团关键点。稠密建图被研究了这么多年,原因就在这里。
稠密方案各有各的代价。DTAM、Kintinuous、ElasticFusion 这类经典稠密融合系统吃内存、速度慢,精度也因此受损。神经辐射场 SLAM 的几何质量更好,却背着一个隐式解码器,渲染不再是光栅化,而成了一次网络推理。3DGS 看上去正是答案:高保真实时渲染,没有解码器,也不需要体积积分。
接下来是部署。一个高斯泼溅 SLAM 系统要表示一间小屋大小的场景,通常得占 500 MB 以上。这个数字划分了演示和真能在机器人上跑起来的东西,也是这项工作的起点。
冗余由 SLAM 制造,而非高斯本身
最容易得出的结论是:高斯基元本身就昂贵,解决办法是压缩。我们认为并非如此。诊断才是这篇论文里我们最希望被读到的部分。
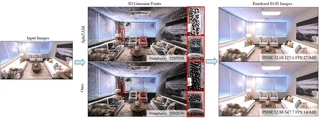
我们观察了这些系统生成的高斯椭球,发现它们的几何相似度远高于原始 3DGS。把高斯归一化到零均值之后再度量相似度,问题就归结为比较协方差,这一步把形状和大小从位置里剥了出来,KL 散度也随之只反映形状与尺度。SLAM 系统里呈现的分布是一根又高又窄的尖峰,离线方法的曲线则低而宽。这些系统在反复存储同一个椭球的近似副本。
原因不在基元,而在优化调度。有两个结构性差异能解释它。
离线 3DGS 一次性拿到全部图像,在所有图像上联合优化,挑选关键帧时也从整个集合里随机采样。SLAM 系统按时间戳顺序接收帧,必须等当前帧训练完成才能处理下一帧,而且只优化被选中的关键帧。同样的基元,顺序的、局部范围的优化,得到的分布却完全不同。在线这一套流程,在某种程度上放大了几何相似性。
这个区别之所以重要,是因为它决定了哪些现成工具能用。离线压缩这一支文献,包括紧凑高斯表示、轻量高斯剪枝、自组织高斯网格,全都假定从一开始就拿到了所有图像、所有位姿和对应的点云。SLAM 是增量优化的。这些方法无论离线效果多好,在结构上就已经出局。
在线压缩为什么棘手
压缩一张已经建好的地图是一回事,在线做要难得多,原因有三。
离线 3DGS 用一个完整带位姿的点云初始化高斯。SLAM 里这样的点云只覆盖相机走过的地方,于是该在哪里增加表示能力,只能基于一张残缺的地图在线判断,而且不知道后面会出现什么。
删除必须因果。判断一个高斯还有没有用,不能去查完整训练集,因为未来的视角还没到。
只看透明度也不对。一个高斯可能透明度很低,却在多个视角里都很关键;也可能占着一块有用的体积,只是颜色贡献不多。把体积和透明度放在一起看,才更接近我们想要的标准。
让网络自己学这个决策,还有一个特有的失效模式。我们的掩码损失把掩码值往下压,稀疏先验本来就是起这个作用;可如果一直压下去不停,优化最终会把地图里每一个高斯都消掉。单向的正则项没有重置,会毁掉它正在正则化的那个东西。
最后,这里的压缩不是后处理。离线压缩量化的是一个已经完成的东西;在 SLAM 里,码本和仍在优化中的属性一起学习,量化器追的是一个还在移动的目标。
先减锚点,再减比特
压缩分两层,顺序不能颠倒。
第一层是结构层面。我们不再存高斯,改存锚点(anchor)。一个锚点由体素中心、一个规模很小的学习特征、一个尺度以及一组偏移组成。高斯中心由体素中心加上每个偏移乘以该锚点的尺度生成;透明度、旋转、尺度和颜色这些剩余属性,则从锚点特征连同当前的观察距离与方向解码得到。承载表示的是结构,而不是一个个基元;解码又依赖视角,所以细节是按视角生成的,不需要按高斯存下来。
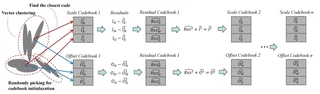
第二层是参数层面,等锚点数量降下来之后才动手。偏移和尺度是每个锚点都必须携带的几何信息,比特主要花在这里。我们用级联的残差矢量量化(residual vector quantization)压缩它们:第一个码本给出向量的粗略近似,之后每一级只量化前面几级留下的残差,索引通过在当前的残差上做最近邻搜索选出。
这个类比来自神经音频编码,而且很贴切。第一个码本粗略描述这个数,后面的码本只描述剩下没说到的部分。码本在整个场景里共享,就像一张调色板被整幅图共用。我们用 K-means 初始化它们。
有两个权衡值得摆出来。级数越多,要存的残差层级越多,推理越慢,而换来的收益很有限。码本越大,很多索引根本用不上,却照样占内存和训练时间;码本小了,精度就要付代价。论文的配置是在大小为 64 的码本上做六级残差量化。另外,缩写值得向接触过粒子滤波的读者说清楚:残差矢量量化和粒子群优化彼此毫无关系,这项工作里也没有出现任何粒子滤波。
哪里优化不动,就在哪里生长
没有运动恢复结构点云可以用来打底,容量该放在哪里就得到线上找答案。我们用的信号是梯度。
如果某个体素里的高斯在连续若干次迭代中始终给出较大的平均梯度,说明优化器在这个位置上还在挣扎,也就有理由认为当前表示无法表达数据想要的东西。当这个平均梯度超过阈值,且该体素中心还没有锚点,我们就种一个下去。候选会被随机淘汰,避免增长失控;无足轻重的锚点则通过累加其高斯的透明度被剔除。
三个分辨率并行工作,每层体素边长缩小到四分之一,梯度阈值翻倍。粗体素吸收墙面、地板这类大块几何,细体素处理椅子腿这样的细节。只用一个体素尺寸,就得让同一个选择同时应付两者,这套多分辨率阶梯因此存在。
初始化是另一条路径:建图开始时,在累计透明度偏低、或者渲染深度与实测不一致的地方采样点。
掩码是调光器,不是开关
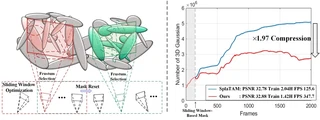
在一个滑动窗口(sliding window)内,每个高斯带一个可学习的掩码参数,再经由带停梯度的直通(straight-through)形式变成二值掩码。渲染之前,这个掩码乘在高斯的尺度和透明度上,被掩掉的基元是从画面里淡出,而不是从数据结构里删掉。真正的移除发生在窗口边界,那里我们同时看命中频率和学习到的掩码。
这个窗口是短期记忆,组成有明确定义:当前帧、与它重叠最多的那个关键帧,以及与当前深度点云视锥重叠最高的两个较早关键帧。视野之外的一切都被视锥剔除冻结,过去的几何因此保留下来,待优化的参数也少了一批。掩码只在关键帧上运行。
让这套机制安全的是重置这个细节。在窗口边界处,移除执行完之后,梯度和掩码一起清零,系统可以重新学。少了这一步,前面说的稀疏压力就再也没有阻力,地图会把自己擦掉。
窗口大小是实打实的权衡,不是随手调的超参数。窗口太大,会把本来还在干活的高斯掩掉,精度受损;窗口太小,内存和优化质量都要付出代价。
跟踪依赖刚刚压缩过的地图
驱动跟踪的有三路信号,它们都来自同一次 alpha 合成。颜色、深度,以及一个只累加可见性权重的轮廓通道。三者共用光栅化,所以轮廓通道几乎不额外花代价。
跟踪在深度有效的射线上最小化颜色误差平方与深度误差平方之和,并用轮廓门控:只有渲染器确信自己确实覆盖了东西的那些像素才被信任。一个 ICP 项把高斯中心与跨帧的最近点关联起来,理由是高斯本身就是一团点云,经典的几何关联方法对它同样适用。位姿用匀速前向投影初始化,消融实验认为这一步不可或缺。
这里的消融最能说明这些部件都在承重。只留深度项,跟踪直接失败;只留颜色项,跟踪能跑,但误差明显更大;去掉轮廓门控,跟踪同样失败。来自渲染器的信任区域确实在起作用,一条光度流水线看来既需要几何项,也需要一块它敢相信的区域。
束调整(BA)在两个尺度上运行。局部调整细化最近的窗口;全局阶段从一个刻意放大的关键帧数据库里采样射线,同时优化地图和位姿,并额外加了一个结构相似性项。这样做是为了在长轨迹和大场景中约束累计漂移,又不必去碰每一帧历史数据。
证据,以及它的形状
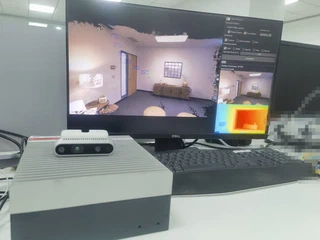
系统在 Replica、ScanNet 和 TUM RGB-D 上评测,硬件既有一个嵌入式模组,也有笔记本级 GPU;此外还有我们自己采集的多传感器移动机器人数据集,用 LiDAR、惯性单元和深度相机记录,场景面积超过一千平方米,并配有高质量的轨迹真值。做这个数据集,是为了回答标准基准回答不了的问题:地图是在移动的机器人上建的,而不是在办公桌上建的,这套表示还撑得住吗。
最有说服力的评测不是一张表格。我们把紧凑表示分别插进 SplaTAM、MonoGS 和 Gaussian-SLAM 里重跑,三者的指标都朝同一个方向改善。这条证据指向的是我们的诊断,而不是我们的系统:一个表示能同时帮到三个不同的系统,说明它触到的是这三者共有的问题。
我们从中得到什么
动手写压缩器之前,先诊断一下你从训练范式里继承来的表示。这项工作有意思的地方不在于设计了一个更好的量化器,而在于注意到顺序的在线优化会产生一种与联合优化不同、也更冗余的分布,并且在写任何代码之前先把它量了出来。
与此相关,任何需要整个数据集的模块,在增量系统里从结构上就不成立,离线表现再好也没用。就这一条约束,排掉了大部分现成文献。
压缩要分两层,先结构、后参数。只做量化,仍然有几百万个基元等着编码;只做掩码,每个基元要背的负载依旧很大。
梯度是容量分配的信号,不只是优化的副产品。这样用它,地图该在哪里更细致,就变成系统自己拿主意的事。
还有一点:任何只朝一个方向施压的学习式剪枝,都需要重置。这个模式的适用范围远超本论文。
它不处理什么
快速运动会给彩色图和深度图都带来运动模糊,而跟踪恰恰依赖这两个损失,所以运动一快性能就下降。动态物体多的场景会产生伪影和漂移,面对高度动态的环境,系统仍有局限。
我们没有实现回环检测和重定位,因此大回环上漂移能校正到什么程度是有边界的。系统只支持 RGB-D,没有单目或双目版本。另外,报告的内存数字需要向读者交代得更清楚:那是检查点大小,不是峰值显存占用,两者不是一回事。
嵌入式为什么重要
这篇论文要说的不是紧凑地图是一种可以接受的妥协,而是紧凑地图依然是一张好地图,同样的质量只需要一小部分存储。这个说法只有在存储真的构成约束时才站得住脚,这也是我们格外在意嵌入式实验的原因。能装进机器人的表示,才会真的被用起来。