MovSAM:基于深度思考的单图像运动物体分割
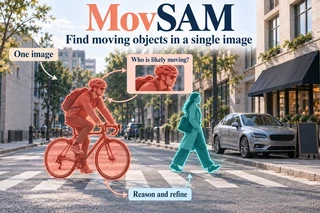
TL;DR 结合视觉语言大模型(VLM)与深度思考认知推理,提出无需光流输入的单图运动物体分割模型。
IEEE/RSJ International Conference on Intelligent Robots and Systems(IEEE/RSJ 智能机器人与系统国际会议,IROS 2025)
 场景语义引导物体分割。
一张照片里没有位移,却蕴含运动
在计算机视觉与机器人自主导航的传统技术谱系中,运动物体分割(Moving Object Segmentation, MOS)历来被理所当然地定义为一个时间差分测量问题:通过比对连续相邻视频帧,或者求解逐像素的光流场(Optical Flow),发生表观位移的像素区域便被划定为运动物体。这一时序前提是如此根深蒂固,以至于整个领域几乎默认了一个技术假设:没有时间序列,运动分割便无从谈起。
然而,在极其严苛的真实物理世界中,基于时间测量的流程频繁遭遇结构性失效:
- 静态意图与前驱运动:行人在斑马线边缘前倾重心、准备跨步的瞬间,其身体在像素空间内的瞬时位移几乎为零,光流法完全无法捕捉这一强烈的动态意图;
- 自运动(Ego-Motion)与动态物体的深度缠绕:当搭载相机的机器人或无人机自身高速移动或颠簸时,画面中所有像素都在剧烈变动。差分计算无法解耦哪些位移源自相机的刚体自运动,哪些源自环境中的独立动态目标;
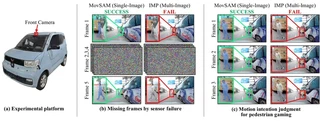
- 动态遮挡与瞬态观测丢失:在传感器丢包、无线通信间歇性中断或相机快门高动态捕获的工况下,算法只能拿到孤立的单张单帧图像。传统基于时序的多帧模型因缺乏历史状态无法降级运行,只能彻底陷入停滞。
这项工作源于一个质朴却深刻的物理直觉:人类在观察一张定格的照片时,往往能够毫无困难地指出画面中哪些物体正在运动、甚至预判其接下来的轨迹。人类并不依赖肉眼测量微小的帧间像素漂移,而是通过对场景物理语义的深度阅读:奔跑者前倾失衡的身体姿态、被气流掀起的衣角发丝、脱离地面的车轮悬空状态、以及高速移动产生的边缘运动模糊。运动在这里并非测量出的物理量,而是通过语义推理与常识归纳得出的因果断言。
MovSAM(发表于 IROS 2025)正是旨在赋予机器人这种超越瞬时测量的单图像运动推断能力。通过构建多模态大模型深思引导的“提出—分割—批判”闭环,我们探索了如何在完全缺失时序维度的极端条件下,从单张静态图像中稳健分割出潜在的运动实体。
既有时序与大模型方法的盲区
为了解决无时序条件下的动态理解,现有算法路线各自存在无法回避的技术短板:
- 时序光流与视频分割范式:经典视频分割方法极度依赖两帧或多帧之间的高信噪比运动线索。它们并非在“利用”时间信息,而是在“消耗”时间信息。一旦将输入截断为单张静态切片,整套依赖特征相关(Cost Volume)与时序记忆传播的网络架构便彻底失效,输出退化为全零掩码;
- 通用大模型与 Segment Anything(SAM)的表征错配:Meta 发布的 SAM 模型具备非凡的零样本通用分割能力,但其原始设计面向点(Point)和几何包围盒(Box)提示,并不具备原生的自然语言指令接口。更致命的是,SAM 的视觉骨干专注于底层边缘、纹理与颜色梯度的解算,完全缺乏全局场景因果理解能力,它根本无法区分哪块具有清晰边缘的纹理属于静止背景,哪块属于正在移动的实体;
- 视觉语言分割(Reasoning Segmentation)的运动盲区:近年来涌现的开集指令分割网络(如 LISA 等)尝试将多模态大语言模型(MLLM)接入分割网络。然而,这类方法的核心落脚点在于“识别物体是什么”(Object Categorization),而非“判定物体是否在动”(Motion Reasoning)。它们在面对“运动错觉(Motion Illusion)”时表现极其脆弱——例如一辆喷涂了动感赛车条纹但静止停泊的汽车,或者一幅印有奔跑运动员的街头广告牌,常规模型极易产生虚假激活;
- 单向级联架构的幻觉累积:简单地将 MLLM 生成的文本提示单向输入给分割网络,在复杂非结构化场景中往往导致灾难性的误差传递。大模型生成的文本描述可能存在空间错位或物体混淆,而下游分割网络由于缺乏反思通道,只能机械地将错误提示渲染为离散掩码,整个系统缺乏纠错韧性。
单图推断运动的物理与几何困难
在没有时间跨度的静态图像中,分割运动物体面临着一系列本质的理论困难:
- 特征的启发性而非充分性:单张图像中所有可用的运动表征(如衣物飘动、离地腾空、单一支撑点倾斜姿态、径向运动模糊)本质上都是经验启发式线索。它们暗示运动的存在,但没有任何一条在严格物理意义上能够充要证明运动。模型必须综合权衡环境重力场、支撑接触面与力学平衡,才能做出合乎物理规律的推断;
- 自运动不可观测定理:在单张图像中,绝对自运动在数学构造上是不可逆重构的。画面中若出现倾斜地平线或模糊,无法仅凭单帧纯几何测量区分出“是周围物体在动”还是“相机自身在旋转倾斜”;
- 视觉空间细节与高层语义的表征鸿沟:SAM 提取的高分辨率图像嵌入(Image Embedding)富含精细的几何边缘与像素级空间坐标,但缺乏语义类别先验;视觉语言模型(VLM,如 BEiT-3)产生的多模态嵌入具有强大的概念推理能力,但在空间分辨率上极度粗糙。如何让两者在不相互污染的前提下实现无损对齐,是算法架构设计的核心挑战;
- 监督信号的稀缺与构造:全球计算机视觉界从未存在专门标注“单张图像运动物体”的大规模真实数据集,因为这个标签本身就带有主观推理属性。我们必须通过逆向清洗主流视频运动数据集,剔除自运动干扰严重的片段,提纯出具备明确单帧物理运动表征的独立图像,自研构建评测基准。
闭环假设验证:让掩码成为可以被反思的主张
针对上述难题,MovSAM 放弃了脆弱的单向流水线,而是将感知过程构建为一个类似科学家探索假说的闭环推理系统:语言负责生成运动假设,分割网络负责将假设落地为像素级几何主张,反思模型则对生成的视觉证据进行冷酷批判并迭代修正。
整个系统由三个紧密协同的阶段构成:
1. 深度思维链引导的运动假设提出(Deep Thinking Proposer)
多模态大模型首先观察整幅图像。为了防止模型在开放词汇空间中发散甚至产生视觉幻觉,我们设计了结构化的深度思维链(Chain-of-Thought, CoT)推理流程:
- 智能体首先遍历场景中的所有显著实体及其空间相对布局;
- 结合重力常识与力学平衡条件,重点扫描不具备稳定物理支撑的物体(如空中飞鸟、投掷出的球体、抬腿奔跑的行人);
- 输出带有显式几何定位与运动因果的标准化文本描述:$\mathcal{P} = \langle \text{类别}, \text{空间相对方位}, \text{推断运动动作}, \text{物理线索理由} \rangle$。例如输出:“画面右上角有一只正在空中滑翔的飞鸟,双翼展开且完全脱离树枝支撑”。
2. 特征聚合网络与多模态像素分割(Grounding Segmenter)
在分割网络中,我们以冻结权重的 SAM 2 图像编码器为基础提取稠密空间特征,引入预训练的 BEiT-3 视觉语言模型注入高阶语义理解。针对表征错配问题,我们设计了轻量级的 特征聚合网络(Feature Aggregation Network, FAN):
- FAN 由五层带有跳跃连接的二维卷积层与自适应全局池化层构成。它反向操作:并不试图让 SAM 具备高阶语义,而是提取 SAM 图像嵌入中的多尺度空间拓扑信息,将其压缩为一个紧凑的空间先验向量,随后无缝拼接至 BEiT-3 的多模态输入流中;
- 调整后的提示编码器接收融合了空间先验的多模态特征,直接激活 SAM 的掩码解码器,输出候选二进制掩码 $\boldsymbol{M}^{(k)} \in \{0, 1\}^{H \times W}$。
3. 多模态反思批判与循环修正(Reflective Critic Loop)
这是 MovSAM 区别于以往所有指令分割模型的关键所在。生成的候选掩码被半透明色彩高亮渲染回原始图像中:
$$I_{\text{overlay}}^{(k)} = \alpha I + (1 - \alpha) \text{Color}(\boldsymbol{M}^{(k)})$$渲染后的合成图像被重新交由 MLLM 批判者进行多维度审查:
- 语义正确性检验:高亮区域覆盖的实体到底是否真正处于运动状态?是否误将背景静态雕塑或反光广告牌划入?
- 空间完整性审查(Under-Segmentation):掩码是否漏掉了运动主体的关键附属部分?(例如分割了奔跑的人体,却漏掉了其甩起的双臂或腾空的脚踝);
- 边缘纯净度审查(Over-Segmentation):掩码是否由于边缘溢出,把不动的地面阴影或邻近静止护栏错误吞噬?
若批判者判定当前掩码不符合物理真实,它将明确驳回当前结果,并生成带有精准修正意见的二阶提示词(例如:“驳回初版掩码:当前掩码仅包含了飞鸟的主干身躯,遗漏了展开的右侧翅膀,请向右上方向扩充边缘”);分割网络根据新提示重新计算掩码,进入下一轮迭代。系统设置最大迭代上限为 5 轮,一旦批判者认可其物理一致性,循环立即收敛输出。
网络训练与复合损失函数
为了在最大化保留基础模型开放泛化能力的同时适应单图像运动推断任务,我们采取了分层微调策略:
- 参数冻结:SAM 2 的 ViT 大规模图像编码器全程保持权重冻结,以保留其在数亿图像上建立的通用底层边缘提取能力;多模态大语言模型(如 GPT-4o 或开源本地 Qwen-VL)以黑箱 API 或冻结模式运行,保障其通用因果常识不受任务微调的表征侵蚀;
- 优化模块:仅对特征聚合网络(FAN)、视觉语言适配器以及 SAM 的轻量级掩码解码器进行端到端联合训练;
- 复合分割损失函数:结合二值交叉熵(Focal BCE)与连续 Dice 损失函数,构建均衡的监督目标: $$\mathcal{L}_{\text{seg}} = \lambda_{\text{BCE}} \mathcal{L}_{\text{BCE}}(\hat{\boldsymbol{M}}, \boldsymbol{M}_{\text{gt}}) + \lambda_{\text{Dice}} \left(1 - \frac{2 \sum \hat{\boldsymbol{M}} \odot \boldsymbol{M}_{\text{gt}}}{\sum \hat{\boldsymbol{M}} + \sum \boldsymbol{M}_{\text{gt}}}\right)$$ BCE 负责逐像素把控精细边界分类,Dice 损失则有效规避了微小运动物体在整幅高分辨率图像中所面临的严重前景/背景正负样本失衡问题。
实验评测与消融洞察
我们在主流视频分割数据集的独立单帧抽样基准,以及由真实机器人车载相机采集的非结构化图像测试集上进行了系统评测:
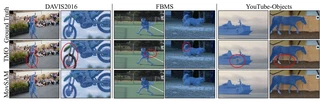
- 与传统时序模型的静态退化对比:当人为截断为单帧输入时,传统基于光流与时序记忆传播的视频目标分割算法(如 ProMRA、DeAOT)因缺乏时间差分线索而近乎完全瘫痪,只能输出全零或严重破碎的掩码;而 MovSAM 依靠 LLM 与 VLM 的高层场景因果推理,在单张静态图像上实现了稳健的分割表现,证明了常识物理推理填补时序空白的可行性;
- 批判反思循环的边际收益:消融实验表明,在加入 LLM 多模态批判反思机制后,复杂动态遮挡与细长四肢漏分割的现象显著减少。多轮迭代使得最终输出不仅是“几何上的边缘聚类”,更是“语义上经得起物理推敲的完整实体”;
- 特征聚合网络(FAN)的不可替代性:若将 FAN 模块移除,直接将未经空间调制的 VLM 语义特征强行灌入掩码解码器,分割边界会出现大面积锯齿与结构断裂,充分印证了跨模态空间细节补偿机制的关键作用。
物理局限与未来演进
在论文中,我们以严谨的学术态度指出了基于单帧纯语义推断运动的客观物理边界:
- 纯粹刚体匀速平移的不可推断性:如果一个表面光滑的刚性球体在无摩擦平面上以匀速低速滚动,且未产生任何运动模糊、形变或阴影脱节,那么在任何单张照片中,该物体与静止状态在物理上是完全不可区分的。MovSAM 的推断基于常识物理线索,无法创造物理世界本身未曾留存的信息;
- 多轮批判带来的推理时延:由于引入了大语言模型的多轮反思对话,单帧全流程推理耗时在当前硬件条件下处于秒级范围,尚无法直接满足百赫兹级的高速动态避障需求。其现阶段的主要应用场景在于高层态势感知、离线故障时空诊断以及通信降级状态下的关键目标锁定。
总结与工程反思
MovSAM 的核心学术贡献,在于向领域展示了:语言与多模态常识不仅可以用于描述世界,更可以作为一种强大的先验假说,去恢复由于物理传感器受损而缺失的物理时间维度。
通过将基础感知模型(SAM 2)、跨模态对齐网络与大语言模型的深度反思能力有机编织为一个自愈闭环,系统在极度匮乏时序观测的严苛工况下依然保持了对真实动态世界的理解深度。这一探索为机器人面对传感器偶发失效、非连续通信以及极端非结构化环境时的感知韧性提供了崭新的解题范式。