MID:自监督多模态迭代去噪框架
TL;DR 提出自监督多模态迭代去噪框架,仅依赖含噪观测学习退化阶段估计与残差逆转,无需干净真值实现多模态与科学数据高保真恢复。
IEEE Transactions on Neural Networks and Learning Systems(IEEE 神经网络与学习系统汇刊,TNNLS)
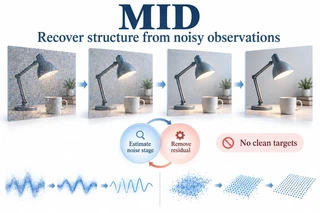 跨模态数据的迭代恢复。
干净版本往往并不存在
好数据是下游一切工作的前提,而采集噪声几乎无处不在:传感器本身的限制、传输错误、环境干扰,还有物理测量固有的随机性。常见的应对是先做去噪。
有两个很实际的事实让这件事比听起来难得多,本文的思路也正是从这两点长出来的。
第一,真正需要处理的噪声很少是高斯噪声。低照度成像中的泊松噪声、压缩伪影,以及我们称作结构化噪声的东西(例如一组并不对应场景中任何真实结构的线段),都违反了经典滤波器赖以成立的假设。第二点更根本:在我们关心的许多领域里,干净目标根本不存在。临床影像和遥感经常没有可供对照的无噪参考,也无从采集。论文里的 MRI 实验之所以用替代指标评分,正是因为那些数据集拿不到干净的 ground truth。
训练信号只能从别处来,指望不上成对的干净样本。整个问题就落在这个约束上。
已有方法为什么都是有条件的
经典的去噪方法,从滤波、变换域阈值到非局部均值,都针对特定的噪声模型和数据类型来设计。噪声统计一旦偏离当初的假设,效果就迅速下降。
有监督深度去噪绕开了建模假设,但需要大量成对的干净与含噪样本。偏偏在去噪最重要的那些领域里,这类数据要么采集成本高昂,要么根本无法采集。
自监督盲点方法(blind-spot methods)曾是顺理成章的答案。我们对它的批评是具体的,不是笼统地说它不好。这类方法不需要成对数据,却带着隐藏的模态假设。先把像素遮住、再由邻域把它预测回来的技巧,靠的是图像的空间相关性。点云是无序的,氨基酸序列离散且无结构。对数据不作任何断言的方法能走到这些场景;暗中假设空间平滑的方法走不过去,表现出来的症状就是过度平滑和细节丢失。
特定领域的专用方法也各有各的条件依赖。Noise2Noise 会把细小的解剖结构抹平;Patch2Self 利用了体数据之间的冗余,却要为每个体数据单独训练一个模型,体数据之间的空间一致性容易出问题;DDM2 对初始噪声水平和模态相关的调参都很敏感。到了表面肌电(sEMG),高通滤波能滤掉 ECG 干扰,但信号里重要的低频成分会随之一起被滤掉,因为两者在频域上重叠;模板相减预设了固定的分布形式;神经网络方法常常训练不稳定。蛋白质序列筛选上,常用的按平均汉明距离做贪心选择只依赖一条准则,无法反映序列质量的更多侧面。
我们没有用跑分表来定位,而是画了一张能力矩阵。要回答的问题是:哪些方法既自监督,又能同时处理图像、信号和点集。这个领域里的大多数方法只能做到三样中的两样。
难点在哪里
非线性退化的逆过程没有可用的闭合形式。直接反演泊松噪声、压缩伪影或具有集合结构的干扰都很困难,我们自己的消融实验给出了硬做的结果:单次前向的网络几乎不改变输入数据。网络很难一步学会从含噪到干净的巨大跳跃。这不是实现层面的失误,方法之所以长成现在这样,原因就在这里。
输入的污染程度同样是未知的。含噪样本不会告诉你自己位于退化轨迹的哪一段,也就无从判断该去掉多少、该走几步。
自监督信号只能自己造,捡不到现成的。没有成对样本,能用的标签全是自己生成的,而且它们要同时服务两件事:输入处在退化的哪个位置,以及下一个增量长什么样。
有些时候,噪声根本不是数值。错误的对应关系、无效的线段、冗余的序列,都不是附加在某个量上的幅度,而是关于某个元素该不该留下的判断。要把这类东西减掉,先得把干扰改写成逐元素的属性,这些任务因此采用二分类目标,而不是对残差做回归。
无序、离散的数据直接推翻了常规先验。点云没有顺序,多序列比对是一组离散字符串,按空间网格共享权重、做卷积这类手段在这里都用不上。
方法里还内含着一种取舍。支撑它的一阶近似只在增量足够小时成立。小增量换来线性性,代价是推理时冗长的循环。
继续加噪,就是恢复:局部线性化与数学形式推导
我们的出发点足够反直觉,不妨直说:要学会去掉噪声,得先往里面加更多噪声。
含噪观测不是放在一旁的干净样本的退化版本,它是退化轨迹上的一个状态,而这条轨迹你可以自己接着走。把含噪输入当作起点,一遍遍施加同一个退化过程,就得到一架带标签的梯子:每一级与下一级之间差了多少噪声,你心里清楚,因为差额是你自己加进去的。
设未知的退化流由连续算子族 $\mathcal{D}_t$ 生成,对任意干净真实物理状态 $x \in \mathcal{X}$,在连续参数 $t \in [0, 1]$ 下形成退化轨迹 $s(t) = \mathcal{D}_t(x)$,其中 $s(0) = x$ 为理想无噪数据,而实际传感器捕获的含噪观测 $y$ 对应某个未知时刻的中间态 $s(t_0)$。因为真实物理逆向算子 $\mathcal{D}_t^{-1}$ 通常高度非凸且严重病态,直接求解全局逆映射 $x = \mathcal{D}_{t_0}^{-1}(y)$ 无法通过单次网络前向可靠收敛。
MID 的关键洞察在于:尽管我们在无监督条件下无法直接求解终点 $s(0)$,但退化过程本身在局域具备可模拟性与增量延续性。定义一个步长为 $\Delta t$ 的增量退化算子 $\mathcal{T}_{\Delta t}$,满足:
$$ s(t + \Delta t) = \mathcal{T}_{\Delta t}(s(t)). $$对该算子在局部状态 $s(t)$ 处作一阶展开:
$$ s(t + \Delta t) \approx s(t) + \mathbf{J}_{\mathcal{T}}(s(t)) \cdot \Delta t + \mathcal{O}(\Delta t^2), $$其中一阶残差增量记为 $\Delta s_t \equiv s(t + \Delta t) - s(t)$。若将增量退化步长限制在局部微扰范围内,非线性算子的单步逆向操作即可近似表示为一阶残差的线性相减:
$$ s(t) \approx s(t + \Delta t) - \Delta s_t. $$这种局部一阶近似的核心前提,是假定局部雅可比矩阵在微小步长下接近单位阵,或者非线性形变的主导分量已可被紧邻状态的差分向量充分吸收。这使我们摆脱了对全局非线性反问题的强求,将其转化为一系列局域可逆的微小单步。从一级到下一级的这一步按加性处理,它的逆自然就是减法。噪声网络要预测的残差,就是我们自己生成的两个相邻状态之差。
两个网络,两个问题:联合损失与自适应循环
框架提出两个彼此独立的问题,正因为把它们分开,同一套做法才能搬到不同领域。
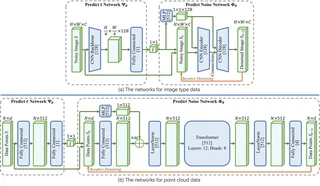
第一个问题是:我现在在哪?阶段预测网络 $E_\phi(s)$ 回归输入在轨迹上的归一化位置 $t \in [0, 1]$。不确定这一点,就无从决定该减掉多少。
第二个问题是:该去掉什么?噪声预测网络 $R_\theta(s, t)$ 接收当前状态和估计出的阶段,输出下一步要减掉的增量。两个网络联合训练,这种解耦是有意为之:一个决定往回走多远,另一个决定每一步卸下什么。
在训练阶段,我们在含噪样本 $y = s_0$ 的基础上,自主施加 $K$ 步已知增量退化,构造级联状态序列:
$$ s_k = \mathcal{T}^{(k)}(y), \quad k \in \{0, 1, \dots, K\}, $$对应的归一化退化阶段标签为 $t_k = \frac{k}{K}$。由于每一步的状态跃迁差值 $\Delta s_k = s_k - s_{k-1}$ 均为完全已知的自生成监督信号,阶段网络与残差网络的目标函数可分别显式写为:
$$ \mathcal{L}_{\text{stage}}(\phi) = \frac{1}{K} \sum_{k=1}^K \| E_\phi(s_k) - t_k \|_2^2, $$$$ \mathcal{L}_{\text{res}}(\theta) = \frac{1}{K} \sum_{k=1}^K \| R_\theta(s_k, t_k) - (s_k - s_{k-1}) \|_2^2. $$在测试推理阶段,对于未知污染程度的初始输入 $y$,系统首先调用阶段估计器得到起始估计 $t^{(0)} = E_\phi(y)$。随后进入反向去噪迭代,在第 $m$ 步执行更新:
$$ s^{(m)} = s^{(m-1)} - R_\theta(s^{(m-1)}, t^{(m-1)}), \quad t^{(m)} = E_\phi(s^{(m)}). $$循环终止条件为 $t^{(m)} \le \epsilon$ 或步数达到上限。轻度污染的输入走的步数少于重度污染的输入,迭代次数随数据自适应,不需要预先设定调度。之所以一步步迭代,而不是一次把噪声全部拿掉,是因为多次小幅修正比一次大幅修正更能保住细节。单次前向被迫一次猜完整段距离,结果往往是过度平滑并丢失高频结构。
去噪是一种问题框定:四维几何匹配与离散集合推广
对我们来说,这项工作最有意思的地方不是图像上的结果,而是把同一套形式指向那些没人会叫作去噪的问题时发生的事情。
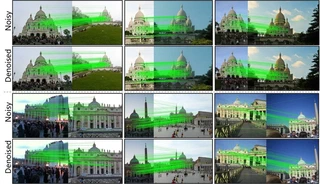
图像对应关系变成四维点云:一对匹配就是两幅视图中各取两个图像坐标所确定的点 $p_i = (u_i, v_i, u'_i, v'_i)$,汇聚为无序集合 $\mathcal{P} = \{p_1, \dots, p_N\}$。错误匹配是不属于几何对极约束的点。然而在无序集合中,常规加性相减失去了物理含义,因为一个错误的几何对应关系无法通过“在坐标上减去某个浮点向量”变成正确的对应关系。
因此,MID 将算子推广为基于集合注意力的逐元素判定。噪声目标改写为逐元素的二元交叉熵损失:
$$ \mathcal{L}_{\text{set}}(\theta) = - \sum_{i=1}^N \left[ c_i \log \sigma(R_\theta(\mathcal{P})_i) + (1 - c_i) \log (1 - \sigma(R_\theta(\mathcal{P})_i)) \right], $$其中 $c_i \in \{0, 1\}$ 表示在自生成退化过程中注入的合成外点标签,$\sigma(\cdot)$ 为 Sigmoid 激活函数。网络不必回答该从错误对应里减去多少数值,它要判断的是这个元素该不该存在。用于消失点估计的线段同样变成无序点集,训练时把随机线段当作几何外点反复加入。
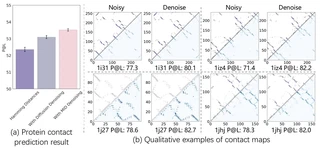
多序列比对则把平均汉明距离偏低的冗余序列视为噪声。最后这个例子里,噪声是真实的氨基酸序列,这足以说明框架评估的是数据质量,而不是合成出来的假象。干扰一旦被表述成可移除的东西,几何估计中的外点剔除、对应关系筛选、线段过滤和序列抽样,就是同一个问题换了身衣服。乘性噪声在对数域可以变成加性,论文提到并用到了这一点。
方法是怎么搭起来的
图像和医学体数据用 CNN 主干做阶段预测,上面接全连接层,增量由 CNN 编码器-解码器给出。点集和一维信号,包括对应关系、线段、氨基酸序列和表面肌电,两个网络都使用全连接层加 Transformer 编码器-解码器。理由前面已经说过:卷积假定数据有空间顺序,无序集合没有,所以是结构跟着数据走,而不是让数据迁就结构。
没有一个领域拿到专门定制的公式,这正是这样搭建的目的。同一套方法用在图像散斑、MRI 噪声、肌肉信号污染、几何外点、错误对应、无效线段和冗余蛋白质序列上,变的只有主干。
我们从中学到了什么
监督信号不必来自干净终点,它可以由你自己继续施加一段可模拟的退化来制造。正是这一处替换,让框架在成对数据不存在的地方也能用。
局部线性化加迭代,把一个无解的全局逆问题变成一串可解的局部逆问题,消融实验就是证据。单次前向的模型失败时,正确的反应不是把模型做大,而是分解。
把“我在哪”和“该去掉什么”分开,是同一套框架能够迁移的原因。相比任何结构上的选择,这项解耦才是可复用的部分。自监督策略里藏着模态假设,值得逐个审视。对数据结构不作任何断言的表述,会比暗地里要求平滑性的表述走得更远。迭代是保住细节的机制,而不只是优化上的便利。
它在哪里止步
极端噪声是论文明确指出的失效场景。信号结构几乎被完全淹没时,局部线性化展开的前提不复存在,迭代相减能依赖的部分结构太少,后续工作我们指向生成式先验这个方向。
第二个代价是时间。迭代必然比单次去噪慢,对实时使用是瓶颈。我们建议的补救办法是知识蒸馏和更高效的采样。
方法里还有两件事我们看得见却没有刻画清楚。加噪步数和每步增量的大小属于设计选择,不是推导出来的量,我们没有研究方法对它们的敏感性。阶段估计的误差还会在随后的每一次相减中累积,这种传播值得我们投入比现在更多的关注。
这属于哪一类模型:与扩散模型(DDPM / Score-SDE)的本质边界
有一条边界值得说清楚,因为每次谈起这项工作都会碰到它。MID 不是生成模型。
扩散模型基于随机微分方程(SDE)框架,其前向过程设计为一个显式的 Ornstein-Uhlenbeck 漂移扩散过程:
$$ \mathrm{d}x = f(x, t)\mathrm{d}t + g(t)\mathrm{d}w, $$其核心数学要求是当 $t \to T$ 时,边缘分布必须渐近收敛至已知的各向同性高斯先验 $p(x_T) \sim \mathcal{N}(0, \mathbf{I})$。这导致扩散模型本质上是在学习经验数据分布的分数函数(Score Function)$\nabla_x \log p_t(x)$,核心价值是从纯白噪声中随机采样出符合经验分布的新数据。
MID 的定位与此存在本质差异:
- 先验分布假设不同:MID 从未假设退化的终点是高斯分布。它的退化算子可以是物理传感器的暗电流截断、结构化几何外点插入或离散字符冗余。
- 目标函数不同:MID 并不最小化数据分布与高斯先验之间的 KL 散度,它学习的是确定性或准确定性的局域退化位移向量场,目标是恢复特定观测实例在物理退化前的原生状态,而非采样新的可能态。
- 输出特性的确定性:这也决定了 MID 不具备“无中生有”的生成能力。当输入信号被极端噪声完全破坏、拓扑结构荡然无存时,局域展开假设失效,MID 无法像生成模型那样基于模式先验凭空重构出看似逼真但未经测量的幻觉细节。这种保守性在科学计算与医学诊断等不可容忍虚假幻觉的场景中,反而是至关重要的安全属性。
它去掉的是训练中见过的噪声,输出是输入的更干净版本,不是新样本。这条界线让框架对自己能承诺什么保持诚实。