LNR:通过学习邻域实现鲁棒多模型拟合
TL;DR 提出由粗到细的鲁棒多模型拟合框架 LNR,通过学习最小集置信度初筛与局部邻域特征细化,突破多结构混叠下的组合爆炸瓶颈。
IEEE Transactions on Pattern Analysis and Machine Intelligence(IEEE 模式分析与机器智能汇刊,TPAMI)
 共享观测与相互重叠的几何邻域。
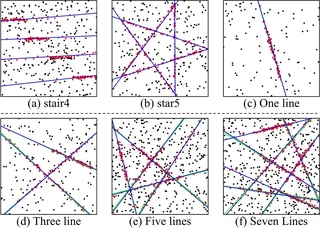
多结构并存下的最小集组合爆炸:为什么盲目随机选取几乎注定选错
在几何视觉与机器人建图中,多模型拟合(Multi-Model Fitting)要解决的是物理世界中最普遍的混叠现实:场景中往往同时存在数十个不同的几何图元(如多堵交错的墙面、多条道路边缘、多个运动物体的轨迹),且这些结构被淹没在海量的传感器噪声与未匹配外点之中。
在经典几何鲁棒估计中,求解一个基础几何模型只需要极其精简的离散数据点。这就是所谓的“最小样本集(Minimum Sample Set)”——例如在二维空间拟合一条直线只需要 $m=2$ 个点,在三维空间拟合一个平面需要 $m=3$ 个点,求解双视图基础矩阵需要 $m=8$ 对对应点。
如果沿用传统 RANSAC 的均匀随机采样策略,系统会假设每一次无偏抽取都有合理的概率命中正确内点。然而,一旦场景从“单模型”切换到“多模型交织”,这种盲目抽样的数学期望就会发生灾难性的指数坍缩:
设场景中存在 $K$ 个不同的真实结构,若盲目从全部观测中随机抽取两个点,这两个点要么分别属于两个完全无关的物理结构,要么其中至少有一个是环境野点。随着交叠结构的增多与外点率的上升,随机抽取的样本对“恰好全部落在同一个合法结构上”的几率微乎其微。每一组错误的最小采样集,却依然要耗费算力调用底层的代数求解器并执行全量几何残差打分。算力绝大部分都被白白浪费在这些先验即错的候选假设上,这是传统采样机制在多模型场景下的结构性瓶颈。
而如果采用贪心迭代剔除(例如 Sequential RANSAC 先拟合一个模型、剔除其内点再重新开始),又会陷入硬聚类的陷阱:现实中相邻结构往往在交界处共享观测,贪心剔除使得共享观测被前序模型独占,导致紧邻模型失去几何支撑而直接被漏检。
还有三条约束决定了我们最终的做法。方法必须在不知道模型数量的前提下工作,这就排除了一整类把模型数当作输入的方案。速度要能实用。最后,它得能迁移到别的任务,因为每换一个问题就要重新设计一遍的拟合器,算不上通用工具。
真正出问题的四件事
我们把问题拆成四种失效情形,方法的每个部件各回答其中一种。
第一,几何特征没有被充分利用。现有方法要么依赖人工设计的判据,只看得到几何信息的一部分;要么是神经网络,从头到尾没有显式地看过几何。
第二,噪声带来的低效优化。大量求解器调用,花在从一开始就没有希望的点集上。
第三,模型重叠。这是拟合一个模型与拟合多个模型的根本差别,而多数形式化描述连把它表达出来都做不到。
第四,流程不可微。离散的最小集采样和任务专用的最小求解器都处在流程中间,两者都没有梯度。想把基于学习的方法接进来,难就难在这里。仅有的两条绕行路线都不好用:拿可微的松弛替换精确求解器,等于把求解器弄丢了;改用策略梯度估计,就得接受方差。
已有方法没能解决的问题
贪心的单模型扩展带着上面说的硬归属问题。MultiRANSAC 每次迭代拟合 K 个模型而不是一个,这就要求 K 事先已知;K 一大,计算上就变得不划算,因为一次迭代里同时找出好几个好模型本身就很难。
迭代式假设生成是更精细的一类,共同的毛病是时间上的耦合。每个新模型都建立在前几轮的结果之上,随着流程推进,误差会沿着模型重叠处层层累积。我们自己的消融实验如实记录了这里的取舍:把更强的学习式采样器换进 LNR,精度上去了,整个过程也明显变慢。我们主动选了代价小的那一边,并且把代价写在论文里。
聚类式方法,包括偏好集聚类和把最小集判为有效或无效的网络,在各自针对的问题上表现不错,却没有考虑数据的复用。评估一个假设时得到的信息,不会带到另一个假设的评估里去。
还有一类方法用全局能量函数替换采样启发式,能量由几何误差和聚类规整项构成;也有人用归属能量的凸松弛,或者在超图上做模式搜索。这些形式化在构造上就能处理重叠,代价是所用代价函数足够复杂,复杂到未必能充分利用数据里真实存在的几何信息,迁移到多样而复杂的场景时效果因此受限。
利用并行计算的高效采样方法很强,但它们需要把实例数量当作先验,适用范围受限。
最后是端到端深度方法,精度不错,以黑箱方式工作。这对可靠部署来说是实打实的障碍,也正是我们不想造的东西。
在决策点上学习,以数据点为条件
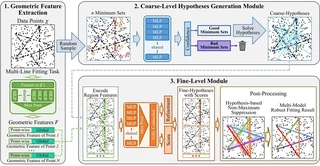
我们的做法是把经典流程原封不动保留下来,只把学习放到真正做决策的地方:求解之前,决定哪些最小集值得占用一次求解器调用;求解之后,决定每个假设该往哪里动、它又有多好。
关键的设计选择是网络以什么为条件。所有被学习的量都是数据点几何特征的函数,与假设参数无关。正因如此,采样器和求解器才能留在流程里,在前向过程中作为不可微的黑箱存在,不需要任何梯度穿过它们。
这里需要说准确,因为很容易讲过头。求解器在训练中是参与了的:两个分类器的标签都来自把求解得到的假设与真值实例作比较,粗层的标签也来自对采样集合的求解。没有发生的事情,是穿过求解器或采样器反向求导。两者只走前向。
每个点先用 Fourier 特征映射提升空间频率的编码能力,再经过以逐点卷积实现的共享多层感知机,最后最大池化成全局描述子。逐点特征与全局特征拼接成 256 维向量,其中局部 128 维、全局 128 维,于是每个点既带着自己的局部几何,也带着对整个场景的一份概括。粗层模块需要这种整体视角;后来我们发现,细层模块并不需要。
求解之前先筛选
粗层模块随机抽取大量最小集,数量刻意取得偏多,以保证覆盖足够广,然后为每个集合预测一个置信度。只有得分最高的那些能走到求解器面前。
这里有两件事值得展开。第一,采样为什么一直保持随机,而没有变成迭代式。随机采样避开了迭代式生成器那种误差累积,也能保住对整个观测集合的覆盖。这是务实的折中,不是最优解,我们在文中也这么写了。
第二,置信度按二分类问题来训练,这意味着模块学会了挑选有希望的最小集,却不需要任何显式的退化检验。经典流程会写死若干检查来拒绝退化构型(degenerate configuration);在这里,拒绝是从求解结果与真值的比较里学出来的。我们把一条手写规则换成了一条学出来的规则,好处在于它随数据改变,而不随写规则的人改变。
去掉粗层模块,性能掉得很明显,因为细层网络应付不了那样堆积起来的候选数量。分开预训练粗层、而不是两层联合训练,效果同样更差,原因正是整套训练设计里最有意思的地方。
用邻域判断一个假设
对每一个存活下来的假设,我们划出一块邻域(neighbor region):在某个任务相关的距离度量下离它足够近的那些数据点。直线用欧氏距离,消失点用方向距离,平面用重投影误差,运动用归一化极线约束。邻域内的点先被编码,再把每个点到该假设的残差拼接到它自己的特征上,点数不足的邻域用零填充以便批处理,最后由两个头读取结果。
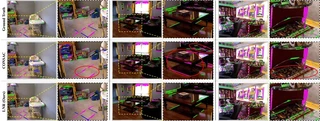
一个头预测的是增量,不是一个完整的模型。直线任务里,它预测两个端点各挪一点点;消失点、单应或者基础矩阵任务里,它预测一个对应的调整量,这个调整量直接加到粗层假设上。网络从不凭空造模型。核对并修正一个猜测,比从零生成一个要容易,所以生成交给经典求解器,修正交给网络。
另一个头预测评分。论文在这里的立场常常让人意外:一致性最大化并不偏向最好的那个模型。内点计数是衡量假设质量的标准代理指标,模型一旦重叠,它就是错的代理指标。取而代之的,是从假设周围的数据里学出评分。
邻域表征也是重叠之所以能被表达的原因。两条相交直线在交点附近共享一块邻域,那里的点同时落在两个邻域内部,为两个假设都提供证据。整个流程里没有任何地方做硬归属。
细层模块还刻意丢掉了粗层所依赖的全局上下文。细化单个假设时,局部细节更有用;全局信息会带进来许多无关细节,反而拖慢这件事。同一个特征在筛选时帮忙,在细化时添乱。这种不对称是一条可以复用的由粗到细原则,也说明两个模块不能简单看作同一个网络跑了两遍。
决定场景里有几个模型
打过分的假设是冗余的。好几个假设描述的是同一个结构,而答案里它只该出现一次。我们把目标检测里的非极大值抑制(non-maximum suppression, NMS)搬到这个场景,把交并比换成几何意义上的相似度:直线看端点距离和夹角,消失点看高斯球面上的邻近程度,单应和基础矩阵则看逐点距离向量之间的相似度。
决定场景里有多少个模型的,也是这套机制。模型数量是抑制过程的输出,而不是方法的输入,这正是我们一开始就想要的效果。
两个模块如何互相训练
三个损失。粗层置信度和细层评分都用二元交叉熵,标签由候选与真值实例的相似度导出。细化头用 Smooth L1 目标函数监督参数增量。
需要解释的是两层之间的耦合。细层的损失会回传到粗层模块,于是选择器学到的是优先挑那些细层能处理得动的假设,而不只是去匹配一个预先定好的标签。两个模块共享编码后的邻域特征,梯度通路就是靠这一点存在的。联合训练优于预训练粗层,原因在于细层的信号重新定义了粗层眼里什么算好。
消融实验里还有一条我们事先没想到的观察。只用更难的场景训练,也就是画面里直线更多的那种,效果与用简单场景训练持平,甚至更好。我们把它归因于数据变化更大,起到了正则化的作用。用来对照的基线采样器上,同样的效应也出现了,只是弱一些。
我们从中得到什么
让学习和不可微部件解耦,靠的是换掉网络的条件,而不是把它们变可微。这份克制是本文方法上最强的表态,也正是精确求解器得以保留的原因。
选择器要对下游的兼容性负责,而不是只对着自己的代理标签优化。预训练会丢掉联合训练能保住的信息。
一致性不等于质量。模型重叠的时候,内点计数是错的度量;把它当成对的,模型就会被少算。
一个特征的价值取决于它出现在哪个阶段。全局上下文对筛选有利,对细化有害。
还要把多实例做进结构里。如果接口规定每个点只能进一个模型,那么无论怎么训练,都表达不了两个。
它假设了什么
两个分类器需要真值实例作为监督。在没有真值模型的领域里表现如何,我们没有刻画。
邻域半径和采样预算是任务相关的量,除了说它们会随任务变化,我们没给出设定办法;抑制阈值同样没有写出来。
跨任务迁移意味着要重新推导四个任务相关的部件:邻域的距离度量、求解器、细化的参数化方式,以及抑制时的相似度。这些是针对每个任务的实际工程工作,我们不宣称零样本迁移。
面对长度不一的邻域,零填充是我们唯一的办法;点很少的邻域会不会因此被稀释,我们没有考察。
随机采样是折中,不是最优。我们自己的消融显示,更强的采样器能提高精度;而一个便宜的学习式采样器能否两头兼顾,我们没有给出答案。
为什么保留两段式流程
保留既有的两段式策略,理由很具体:可解释性。数值方法天生可解释,适用范围也界定得清楚,缺点在于难以充分利用数据的几何特征。端到端深度方法表现很好,却说不清自己是怎么得到结果的。
LNR 保留了流程,输出就是显式的几何模型。网络接受通用的无序点集,图像对应、三维点云和像素坐标都包含在内;损失作用在几何特征上,而不作用在假设上。正是这一点,让它能和各种各样的求解器与采样过程兼容,可微与否都不影响。
我们给自己定的目标刻意不高。希望它为用学习的方式处理多模型拟合带来一点新想法;比起一个精度说不清来由的方法,我们更愿意要一个行为经得起追问的方法。