基于激光雷达–相机融合与 IMM-UKF 的高速公路三维目标检测与跟踪
TL;DR DTFI 结合局部激光雷达与相机特征融合及 IMM-UKF 多模型滤波,实现高速公路场景中的三维车辆检测与跟踪。
IEEE Transactions on Emerging Topics in Computational Intelligence (TETCI), 7(4): 1242–1252, 2023

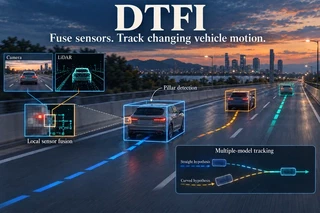 融合观测支持连续车辆跟踪。
每两米就盲一次的感知
这项工作真正的设计约束是延迟,而不是精度。
多数基于融合的三维检测算法在工作站上也只有不到 15 Hz,而开车的并不是工作站。车载计算平台算力更低,而且它并不专供感知:规划、控制以及整个系统的其他模块都要同时运行,同一份预算还要再被分走一块。
把 15 Hz 的代价换成一个具体数字。高速行驶时,相邻两帧之间车辆前进约 1.94 米。在这段距离里,感知系统实际上看不到刚刚发生的变化,我们把这叫做时间盲区(time blind)。后果一点都不抽象:一个按两米之外那辆车的位置做反应的系统,反应的是一个已经不存在的场景。
30 Hz 能大幅缩短这段盲区,也给其他模块留出运行空间。这个目标,以及它必须在可负担的硬件上、而不是在开发机上达成,决定了论文里的每一个选择。它还意味着我们做了一次有意的取舍:纯激光雷达方法的检测精度高于融合方法,我们从一开始就没打算在这一轴上赢过它们,目标是在它们达不到的频率下依然有竞争力。
三类融合方案各自的代价
把图像和点云结合起来的路子有三种,每一种都要付出代价。
先在二维上检测、再把框提升到点云里的视锥(frustum)方案,会让整个系统依赖那个二维检测器。图像分支一旦出错,误差就传到三维,没有挽回的余地。
在特征层或候选框层融合、端到端训练,效果很强,代价是区域级融合的过程会丢掉原始信息。这类方法往往结构复杂、运行缓慢,而运行缓慢正是我们要解决的问题。
第三类把点云投影到图像特征图上,用在那里找到的内容增强每个点。架构因此离纯激光雷达检测器很近,这正是我们想要的;柱状编码器又把运行时间压得很低。我们选这一类,理由就在这里。
纯激光雷达检测这一支同样有谱系可循。基于体素的三维卷积精度好,速度慢。稀疏卷积提高了效率,还是不够快。柱状表示把问题降到二维卷积,在精度与速度之间取得了最好的平衡,我们就建在它上面。
跟踪环节用经典滤波器而不是学习式滤波器,是有意为之,不是图稳妥。学习式跟踪器在实时条件下的表现很差,拿神经网络做数据关联又太耗时,匈牙利算法因此保留下来。批处理式跟踪被排除是另一个原因:它要用到全部数据,而行驶中的系统永远只有历史。二维跟踪也被排除,因为它给不出目标在三维中的位置和尺寸。
滤波器方案里最接近的一个是知名的三维跟踪器,简单高效,只用一个匀速模型。匀速模型无法表示正在转弯的车辆,它的状态估计于是恰恰在预测最要紧的场合退化。还有一个单目跟踪器,在一台相机下使用扩展卡尔曼滤波。城市道路场景中也有一套 JPDA-IMM-UKF 系统,检测环节用传统聚类,跑出来的轨迹是碎的,下游跟踪因此受影响。
IMM 本身在航空领域是标配,在车辆上却几乎见不到,原因很说明问题。飞机的机动幅度很大:速度变化大,航向变化快,切换模型值得那份复杂度。车辆运动要温和得多。再加上汽车场景里可供参考的工作很少,IMM 需要的那些参数很难设定。
难在哪里
在完整图像分辨率下逐点融合,还要跑满 30 Hz,这首先是算力预算问题,其次才是精度问题。每个点挂多少图像通道,就是你手里那个旋钮;我们把它当作取舍来调,没有一味取最大值。
数据层融合(data-layer fusion)还有一种安静而具体的脆弱之处。每个点都要对应到一个图像位置,标定一旦有误差,采样到的特征对每个点都落在错误的像素上,而由此得来的输入看上去完全合理。没有任何错误信号,系统并不知道自己拿到的是垃圾。
如果非选一个运动模型不可,那就怎么选都吃亏。匀速模型简单,处理直线运动很强。恒转率恒速模型能处理旋转。单独用哪一个,在对方的场景里都会出错。答案是在两者之间切换,而切换又带出一组先验参数:状态切换矩阵、状态协方差、过程噪声与量测噪声协方差。按惯例这些参数凭经验设定,而经验值并不能保证适用于另一个场景。这是实打实的方法问题,不是调参上的小麻烦。
非线性问题同样存在。匀速模型的转移对状态是线性的。恒转率模型的转移里,位置由速度、偏航角速度乘以航向的正弦与余弦表示,这是非线性的,滤波器因此需要 sigma 点,不能只做一次普通的卡尔曼更新。
跟踪还得同时扛住中断、抵抗噪声。遮挡会让检测丢失,对新建轨迹过于宽松又会放进检测器的误检。这两种失效模式的方向正好相反。
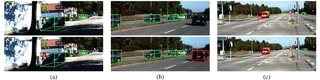
物理条件还给检测设了上限,与架构无关。在我们的一个例子里,三辆很远的车各自只返回三到五个激光点。点太少,检测就是不触发。
附加邻域,而非单个像素
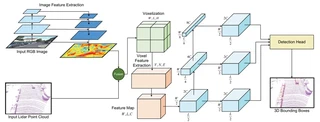
这个思路的前一半,针对的正是数据层融合的脆弱。我们不在投影位置上只采一个像素,而是在投影点周围取一个 5 × 5 的图像特征窗口,把整个邻域附加到这个点上。
这样一来,网络学到的是两个模态之间的对应关系,而不是完全信任标定。一个点的投影偏了一两个像素,它仍能在自己的窗口里找到相关的外观特征。这是检测这一半里最有价值的一次概念上的改动,也正是它分开了两种融合:一种扛得住标定误差,另一种会无声地退化。
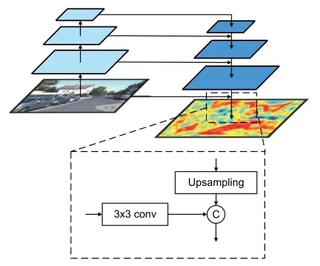
特征取自一个全分辨率的提取器,理由与上面相关:点必须映射到精确的图像位置,这个窗口才有意义,而降采样的特征图会毁掉这份精度。编码器以 VGG 为基础,改了两处。我们把通道数压下来,让优化过程可控;又在网络中间截断,避免特征图缩得太小,缩得太小就没法用来生成融合数据。自顶向下的解码器做上采样,与同分辨率的编码器特征图合并,输出维度由 1 × 1 卷积控制。
压掉高度轴,换来帧率
增强后的点随后进入柱状编码器。点被分配到鸟瞰图网格里,网格有单元尺寸,每个单元能留多少个点也有上限,超出上限的部分随机下采样。高度轴被压成一个单元,这就是把三维卷积变成二维卷积的那个技巧,帧率正是从这里来的。
每个点带着自己的几何与外观,另外还有五个偏移特征,描述它相对于所在单元均值和体素中心的位置。一个 PointNet 层把这些特征扩展开,最大池化把每个单元压缩成一个代表,再把这些单元散布回一张伪图像。接着由二维卷积骨干和区域候选头预测带朝向的三维框。
柱状表示的代价有两处:单元内部的高度结构被丢弃,检测范围被相机视场限制住,因为融合需要像素。这两点我们都接受,算作达成频率目标的代价。
有一项损失值得单独说,它看起来多余,其实不然。偏航角残差取预测角与锚框角之差的正弦,而正弦是对称的。车头朝前和车头朝后的车给出的残差完全一样。只靠回归分不开这两种情况,损失里因此另设了一项方向分类。
两个运动模型,以及一次对先验的搜索
跟踪器先预测已有的每条轨迹,再按三维重叠度用匈牙利算法把预测与检测关联起来,更新匹配上的轨迹,并对所有未匹配的对象做新生与终止的维护。
有意思的地方在更新这一步。两个模型并行运行,一个用匀速状态,一个用恒转率恒速状态。混合概率由上一时刻的模型权重和切换矩阵算出,为每个模型构造混合估计,各自的 sigma 点滤波向前预测,再把两者合成 IMM 的预测。关联完成后,每个模型用匹配到的检测做更新,模型概率由量测似然重新计算。这一对模型在构造上就是互补的:匀速模型以很低的代价把线性运动估计得很好,恒转率模型补上它处理不了的旋转情况。
轨迹生命周期管理用两条护栏应对中断与噪声之间的张力。未匹配的轨迹会在有限帧数内继续预测,之后才终止,因为一条轨迹失去匹配通常意味着被遮挡,而不是车辆消失,重新起一条轨迹反而会把轨迹割碎。未匹配的检测必须连续多帧出现,才会生成新轨迹,偶尔的误检就被滤掉了。两条规则守的是相反的失效模式。
先验参数是我们偏离惯例的地方。切换矩阵和各协方差没有凭经验设定,我们把它当成一个优化问题,用粒子群优化(PSO)拟合出来。这个名字容易招来误读,值得说清楚:粒子群优化是在参数空间里做无导数搜索,跟粒子滤波毫无关系,这项工作里也没有出现过任何粒子滤波。
关于这次拟合有两点要讲,与其被人发现,我们宁愿自己说出来。优化是离线的,而且按数据集分别进行,所以它不是在线自适应;参数是对拟合所用的那批数据拟合出来的。另外,一个对称的切换矩阵本身并不能说明数据集里的车辆运动更偏向匀速模型,尽管很容易那样去读。
我们从中得到什么
延迟预算是设计的输入,不是事后测出来的指标。一旦跨过实时这条线,剩下的预算才轮到精度,架构就该围绕这个先后次序来组织。
局部感受野是完美标定的廉价替代。两个传感器本来就对不齐,在邻域里学习对应关系,比假设某个像素就是对的好用。
先给问题降维,再去优化网络。柱状化是让整件事成立的那个技巧,不是附带的处理。
在这类问题里,混合表示胜过纯粹的单一路线:学到的外观特征、显式的几何投影、显式的状态估计器,各做各擅长的事。模块化在出问题时也有好处,每个组件都有明确的职责,也有各自的失效特征。
互补胜过调参。两个在不同情况下失效的模型,好过一个在哪都不出彩的模型。
先验一旦真的猜不出来,就去搜。承认 IMM 的经验值可能无法迁移,是这篇论文里最有价值的一句方法论表述。
它做不到什么
老实的总结是:这个系统在精度上有竞争力,但不领先。它在检测速度上有明显改善,精度上仍落后于最好的纯激光雷达方法,这正是我们选的取舍。
IMM-UKF 对运动方向变化很小的目标处理得不好。一个在多种假设之间切换的滤波器,需要有可观测的机动,切换才划算。
检测范围受相机视场限制,这是这种融合设计本身带来的。远处的稀疏目标会失败,前面三到五个点的例子已经说明这一点。跟踪器与检测器是两个分开的阶段,没有联合优化,这是我们在未来工作里指出的方向之一;另一个方向是在不牺牲帧率的前提下把精度做上去。
结语
我们做出来的东西把三维检测与三维多目标跟踪整合成一条流水线,用高速公路行驶的实时要求来衡量:一个高效输出带朝向框的检测器,一个在运动不确定的情况下跟随目标的跟踪器,后者靠的是数据关联、交互式多模型滤波和拟合出来的参数。我们并不是说它是最准确的系统,而是说它的精度在融合方案达不到的频率上是实打实的;在高速公路上,落后世界两米,本身就是一种不准确。