DiffSAC:扩散引导的采样一致性鲁棒估计
TL;DR 面向极高外点率下的几何模型求解,提出首个几何条件扩散导引的采样一致性鲁棒估计范式 DiffSAC。
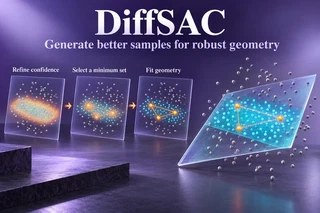 扩散过程细化候选观测的置信度。
昂贵的地方不在采样,而在无效假设的验证
在三维视觉与机器人状态估计中,从带有大量噪声和外点(Outliers)的观测数据中解算几何模型,采样一致性(Sample Consensus, RANSAC)历经四十余年依然是无可替代的工业标准。然而,这一经典范式存在一个往往被工程实践默认承受的结构性沉重代价:候选最小集的生成是廉价的,但对每一个候选模型进行全局外点检验却是极其昂贵的。
在几何估计中,最小集(Minimal Sample Set)是指能够唯一确定模型参数所需的最少观测数量:拟合空间直线需要 2 个点,拟合三维平面需要 3 个点,估计单应性矩阵(Homography)需要 4 对对应点,而在双视图几何中求解基础矩阵(Fundamental Matrix)通常需要 8 对对应特征点(或 7 对)。经典 RANSAC 依赖全局均匀随机抽样。根据几何概率统计,若数据集中外点比例为 $\epsilon \in (0, 1)$,最小集规模为 $s$,为了以概率 $p$(通常取 0.99)至少抽中一组全内点组合,所需的理论迭代采样次数为:
$$K = \frac{\ln(1 - p)}{\ln\left(1 - (1 - \epsilon)^s\right)}$$当外点比例温和时,计算尚可接受;但一旦面临恶劣的野外感知或低纹理重复场景,外点比例飙升至 80% 甚至 90% 时,组合数发生灾难性爆炸。在求解 $s=8$ 的基础矩阵且 $\epsilon = 0.8$ 时,全内点组合被命中的先验概率仅为 $(0.2)^8 \approx 2.56 \times 10^{-6}$,理论上需要执行超过 180 万次迭代。即便在工程中硬性截断迭代预算为几千次,绝大多数算力也彻底耗费在解算那些从物理上就注定错误的模型,并在数千个观测点上反复计算投影误差。
不仅如此,随机均匀采样对几何退化完全无感。两对空间距离极近的特征点,其局部坐标可能高度精准,但在数值上却构成病态的超短基线;三维空间中几乎共面的四个点,在求解双视图对极几何时会导致退化解。均匀采样从不考虑一组点作为一个整体的联合几何相容性,盲目抽样的结果就是绝大部分候选集合在进入代数求解前就已经是无效组合。
既有改进方法的得与失
为了让最小集的提议更加高效,过去二十余年学术界沿着多个方向进行了深耕,但各自保留了难以回避的局限:
- 先验排序与局部邻域启发式:PROSAC 根据特征匹配的局部质量分数(如匹配距离比值)建立排序,优先从高分候选池中抽样;NAPSAC 与 Progressive NAPSAC 则假设内点在欧氏空间中呈现局部聚集特性,限制在空间小球邻域内抽取组合。这类启发式方法在结构化场景下确实能加快收敛,但其缺陷在于:特征匹配质量高并不保证几何分布不退化,而强行限制在局部邻域则极易丢掉跨越大视场的全局长基线约束,在重复纹理(如建筑物玻璃幕墙、地面地砖)产生虚假局部一致性时彻底失效。
- 假设后处理与局部优化:LO-RANSAC、GC-RANSAC 与 MAGSAC++ 反其道而行之。它们放弃对前序采样提议的干预,转而专注于在发现一个初具雏形的候选假设后,通过图割(Graph Cut)、局部内点加权或连续阈值边缘化来精修模型参数。这些后处理算法极其优异,并且我们在最终系统中也兼容了它们;然而,它们从根本上没有触碰“如何在千万级外点中以极少代价命中第一个高质量候选”这一核心瓶颈。
- 端到端可微深度估计(DSAC 系列):DSAC 及其后续工作将离散的假设选择过程松弛化为可微概率分布,使得深度神经网络能够端到端反向传播梯度。这一思路在学术上极为优美,但在工程落地中面临严重的黑箱困境:神经网络内部直接隐式回归模型参数或潜空间权重,一旦在真实自动驾驶或 SLAM 运行中输出严重偏移的位姿,工程团队无法通过残差追溯究竟是哪几个特征点引发了数值漂移,缺乏工业级系统所必须的安全可解释性与故障排查接口。
正是在这一背景下,我们提出了一个直接的问题:能否把最小集的获取过程,从被动的盲目抽样转变为目标导向的条件概率生成? 我们并不试图用神经网络替代底层的经典代数求解器,而是让学习模型专门承担最困难的任务——直接生成极高质量的候选最小集。
生成候选集合,而非被动试错
DiffSAC 的核心构想是:把鲁棒估计中的采样步骤重塑为几何条件扩散模型(Geometry-Conditioned Diffusion Model)的逆向采样过程。如果神经网络能够学习到“在当前观测点云下,能够成功解算出正确模型的有效最小集”的后验概率分布,那么在推理时,我们只需从该分布中生成极少量的候选集合(例如 10 到 20 个),每一个候选组合都具备极高全内点概率与良好条件数,随后交由确定性的经典求解器与共识函数进行评估。
这在概念上与文本生成图像(Text-to-Image Diffusion)形成了有趣的映射:一段文本提示词可以生成多张构图合理但细节略有不同的高质量图像,用户可以从中挑选最完美的一张;同样,DiffSAC 针对同一批几何观测输入,通过注入不同的高斯初始噪声,并行生成数十组各具特色但全部物理合法的最小集候选。
这种设计巧妙规避了传统生成扩散模型在机器人学中遭遇的高延迟批评。在图像生成中,扩散模型必须去噪百万级的像素张量;而在 DiffSAC 中,每个几何观测点仅对应一个连续的标量置信度(Confidence Scalar)。对于包含数千个特征点的场景,整个扩散向量的维度仅为数千维,结合高阶快速数值求解器,整套扩散逆向过程在主流 GPU 上的耗时能够被严格控制在十余毫秒以内,其节约的巨额代数解算与外点残差验证开销,在计算预算上构成了高度划算的代换。
关键的理论抽象在于:这个连续置信度标量代表什么? 我们打破了传统方法将置信度定义为“单个点自身是否为内点”的局限,而是将其严格定义为“该观测点是否与其他被选中的点协同构成一个优良最小集”的集合级联合相容属性。
条件扩散过程与数学形式化
设输入的几何观测集合为 $\chi = \{x_i, d_i\}_{i=1}^N$,其中 $x_i \in \mathbb{R}^d$ 表示观测的几何坐标(例如特征点的二维图像坐标或三维空间点),$d_i \in \mathbb{R}^{d_f}$ 表示局部外观描述子向量(如 SuperPoint 或 SIFT 特征)。
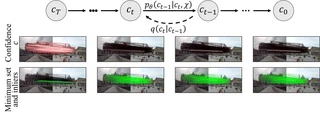
记定义在观测集合上的真实置信度目标场为 $\boldsymbol{c}_0 \in [0, 1]^N$。在连续时间扩散框架下,前向加噪过程定义了在时间步 $t \in [0, 1]$ 下将 $\boldsymbol{c}_0$ 逐步扰动为高斯白噪声的伊藤随机微分方程(SDE):
$$\mathrm{d}\boldsymbol{c}_t = \boldsymbol{f}(\boldsymbol{c}_t, t)\mathrm{d}t + g(t)\mathrm{d}\boldsymbol{w}$$其对应的逆向逆时去噪过程则由概率流常微分方程(Probability Flow ODE)确定:
$$\mathrm{d}\boldsymbol{c}_t = \left[ \boldsymbol{f}(\boldsymbol{c}_t, t) - \frac{1}{2} g(t)^2 \nabla_{\boldsymbol{c}_t} \log p_t(\boldsymbol{c}_t \mid \chi) \right] \mathrm{d}t$$其中条件得分函数 $\nabla_{\boldsymbol{c}_t} \log p_t(\boldsymbol{c}_t \mid \chi)$ 由参数化去噪神经网络 $\boldsymbol{s}_\theta(\boldsymbol{c}_t, t, \chi)$ 进行拟合。整个去噪演变以几何观测 $\chi$ 为硬条件,使得置信度的细化过程受到真实三维对极几何与空间法向的强力引导,而非在无约束流形上盲目游走。
在训练阶段,我们采用真值几何模型生成理想的监督信号 $\boldsymbol{c}_0$:对于给定的真值模型,系统在所有真值内点中随机检索出与模型数值相容的最小集,将入选观测的置信度标定为 1,其余所有点标定为 0。去噪网络采用直接预测干净场 $\hat{\boldsymbol{c}}_\theta(\boldsymbol{c}_t, t, \chi)$ 的 $x_0$-参数化目标,以均方误差损失函数进行端到端优化:
$$\mathcal{L}_{\text{diff}}(\theta) = \mathbb{E}_{t, \boldsymbol{c}_0, \boldsymbol{\epsilon}}\left[ \left\| \hat{\boldsymbol{c}}_\theta(\boldsymbol{c}_t, t, \chi) - \boldsymbol{c}_0 \right\|_2^2 \right]$$在这一目标下,网络被迫学习在含噪置信度场中捕捉哪些点组合在一起能够消除代数奇异性。
置换不变的 Transformer 去噪网络架构
在几何估计中,输入特征点的排列次序是完全人为且随机的。如果去噪网络依赖固定坐标索引或一维卷积,模型就会灾难性地学到输入序列特有的虚假拓扑,且无法应对任意规模可变的点数 $N$。
为此,我们将去噪骨架构建为一个 不带任何绝对位置编码(No Positional Encoding)的置换不变 Transformer:
- 特征投影:将每个观测的几何坐标 $x_i$、外观描述子 $d_i$ 与当前含噪置信度标量 $c_{t, i}$ 进行特征拼接,通过多层感知机(MLP)映射为 $D$ 维的潜在特征向量 $z_i^{(0)}$;
- 全注意力聚合:堆叠多层标准的自注意力(Self-Attention)与跨注意力层。自注意力机制在所有 $N$ 个观测之间建立全连接注意力图: $$\boldsymbol{A} = \text{Softmax}\left(\frac{\boldsymbol{Q}\boldsymbol{K}^T}{\sqrt{d_k}}\right)$$ 在这种机制下,任何一个观测点在调整自身置信度时,都能够依据整个场景中其他所有点的几何距离、视差梯度与外观相似度进行全景加权,这正是评估多点空间相容性所需的数学运算;
- 置换不变性保证:由于完全摒弃了位置编码,对于任意置换矩阵 $\boldsymbol{P} \in \mathbb{R}^{N \times N}$,网络满足严格的等变性定理:$\hat{\boldsymbol{c}}_\theta(\boldsymbol{P}\boldsymbol{c}_t, t, \boldsymbol{P}\chi) = \boldsymbol{P}\hat{\boldsymbol{c}}_\theta(\boldsymbol{c}_t, t, \chi)$。无论输入的点集如何乱序排列,输出的置信度分布严格保持物理一致。
消融实验证实,将 Transformer 替换为 PointNet++ 或基于 k-NN 图卷积的 DGCNN 骨干网络时,模型在复杂大基线匹配下的泛化性能出现断崖式下跌,证明全局全景自注意力对捕捉跨视场长距离几何约束具有不可替代的作用。
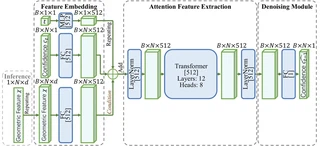
推理流程:并行多副本扩散与快速求解
在测试推理阶段,DiffSAC 采用“批量并发扩散—硬提取—经典验证”的高效流水线:
- 批量副本初始化:将当前帧的观测集合 $\chi$ 在显存中并行复制 $B$ 份(通常设置 $B = 20$)。为每个副本独立采样一个服从标准正态分布的随机置信度向量 $\boldsymbol{c}_1^{(b)} \sim \mathcal{N}(\mathbf{0}, \boldsymbol{I})$;
- 高阶快速 ODE 求解:采用 DPM-Solver++ 高阶显式求解器,将原本需要上百步的离散去噪过程大幅压缩至 10 至 15 个时间步,各副本在 GPU 上以批处理方式并发完成反向去噪,输出收敛的连续置信度场 $\boldsymbol{c}_0^{(b)}$;
- Top-k 最小集硬提取:针对每个副本的置信度场,直接通过硬性
Top-k索引提取数值最大的 $s$ 个观测点,组成候选最小集 $\mathcal{S}^{(b)}$; - 确定性代数求解与共识评估:调用闭式几何求解器(如针对直线/平面的奇异值分解 SVD,针对基础矩阵的归一化八点法或七点法)独立求解模型假设 $\mathcal{M}^{(b)}$。将求得的模型与全量观测 $\chi$ 比对,计算几何投影残差并根据共识评分函数(如 MSAC 或 M-estimator 核函数)遴选出综合得分最高的最终模型。
这种“初始噪声随机、选择过程确定”的设计极为精妙:20 个独立的噪声种子探索了不同的高置信度极值盆地,保证了输出候选的多样性;即使其中某一个副本因偶发退化落在病态解上,其余独立的副本依然能够稳定提供优质候选,彻底消除了单次启发式提议容易陷入局部死锁的风险。
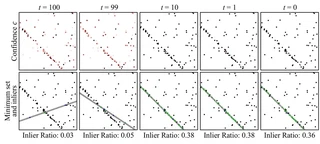
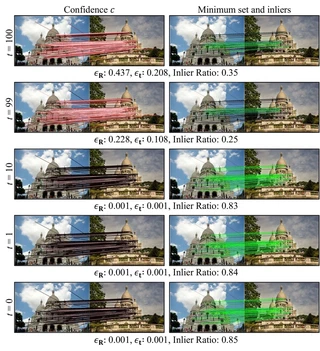
最关键的消融:为什么迭代去噪无可替代?
在审视 DiffSAC 时,一个自然的疑问是:为什么必须使用复杂的迭代扩散过程?直接训练一个前向回归网络,一次性从输入数据中输出置信度向量难道不行吗?
针对这一问题,我们设计了最具说服力的对照实验:保留完全相同的 Transformer 主干网络结构与训练目标,移除迭代加噪去噪机制,让网络从干净的输入 $\chi$ 中直接单步回归置信度向量 $\hat{\boldsymbol{c}}$。
实验结果展现了巨大的鸿沟:
- 直接回归网络输出的置信度场表现出严重的均质化与弥散性,无法在微小几何尺度上拉开内点与退化点之间的对比度差距,Top-k 提取的最小集包含外点的概率极高;
- 相比之下,扩散逆向过程展现出了清晰的逐步自优化行为:在前几个时间步,网络首先利用全局注意力滤除掉绝大部分特征不匹配的外点;在中间时间步,网络开始根据对极几何约束剔除局部共线或视差过小的退化几何点;在最后几个时间步,置信度场迅速极化变尖,将注意力精准聚焦在一小撮高杠杆、大基线的黄金内点组合上。
这一消融雄辩地证明:扩散过程的本质并不是为了追求随机性,而是把原本极其困难的高阶几何组合寻优问题,拆解为一系列沿着梯度场平滑收敛的轻量级低阶细化步骤。
此外,由于 DiffSAC 严格保留了经典的几何求解器与外点共识函数,它与现有的局部优化算法(如 LO-RANSAC、GC-RANSAC)具有天生的正交互补性。当把 DiffSAC 生成的优质初始假设输入给 LO-RANSAC 进行局部二次迭代时,系统的最终估计精度再次获得了显著提升,证明两者的结合完美拼合了“高效宏观提议”与“精细局部收敛”的完整版图。
全面基准评测与局限性审视
我们在合成受控数据集以及包括 ScanNet、MegaDepth、PhotoTourism 在内的多个极具挑战性的真实世界双视图几何基准上,对 DiffSAC 进行了详尽评测。评测任务涵盖了直线拟合、三维点云平面分割、基础矩阵与本质矩阵求解以及单应性矩阵估计:
- 在 80% 超高外点率的极端合成压力测试下,经典 RANSAC 在 5,000 次迭代内求解成功率不足 15%,而 DiffSAC 凭借仅 20 个并行候选提议,成功率稳定维持在 94% 以上,平均估计误差降低了一个数量级;
- 在真实大视角变化与重复纹理场景下,DiffSAC 显著降低了退化模型的生成概率,在双视图位姿估计 AUC 指标上大幅超越了 PROSAC、MAGSAC++ 等强基线算法。
在坦诚审视系统表现的同时,我们在论文中同样明确指出了当前的物理边界与局限:
- 任务特化与泛化边界:当前版本的去噪网络针对特定的几何自由度进行训练(例如针对单应性矩阵与本质矩阵分别需要独立的模型权重)。构建能够跨任务统一处理任意自由度几何约束的通用条件扩散网络是下一步的核心方向;
- 算力与硬件平台依赖:尽管 DPM-Solver++ 将步数压低至十余步,但 Transformer 在处理数千点集时的自注意力计算仍高度依赖 GPU 的张量并行能力。在缺乏强力显卡的微型边缘端嵌入式系统上,其推理吞吐率仍有待进一步工程剪枝与量化优化。
核心主张与工程哲学
DiffSAC 所追求的工程哲学,是对基于深度学习的计算机视觉研究范式的一次理性回归:将学习模型置于真正困难的高维模式识别与组合提议环节,将经典算法坚守在成熟透彻的代数解算与残差共识验证环节。
在几何视觉中,从数万个杂乱组合中找到满足物理约束的极小集是一个高度非凸、高度非线性的困难模式匹配问题,这正是深度神经网络大显身手的舞台;而通过最小集解算模型参数、计算重投影几何误差,则是经典几何学早已彻底解决的解析代数问题,绝不应该被低效、不可控的端到端黑箱网络盲目替代。
这种分工不仅带来了效率与精度的兼收并蓄,更彻底捍卫了复杂工程系统最珍贵的可解释性与安全审计边界。在任何一次估计发生异常时,算法工程师都能清晰地调阅每一个候选集合的置信度流形、追踪对应代数解的特征矩阵条件数,让系统的每一次决策都有据可循、有理可辨。